Chinese Search Sharing

Liang Bo Wang (亮亮), 2015-09-14
繁体完整版本

PyCon China 上海2015

中文搜索经验分享

By Liang2 under CC 4.0 BY license

Esc to overview
← → to navigate

关于我

背景介绍

ES Search Basics

ES 搜索的最小单位是 Term (Token)

Who controls the past controls the future. Who controls the present controls the past. - 1984, George Orwell

会被 ES Tokenizer 转换成 Who / controls / the / past / controls / the / future / Who / controls / the / present / controls / the / past。
实务上会在 tokenizer 前后加上 filter 小写转换、去除无意义的 a、the。

这里 term 有:controls(4), the(4), Who(2), past(2), future(1), present(1)

# python3 tf_idf.py 后背包
Searching 后背包 in 7 documents ...
['复古单宁帆布后双背包',  '米色帆布横式侧背包',
 '蓝色石纹斜背包',       '帆布眼镜盒',
 '鳄鱼来了帆布笔袋',     '拼木纹布质文库书衣',
 '单眼相机用亮彩防水包布']
Top 3 similar documents are:
d1: 复古单宁帆布后双背包 [sim=0.4969]
d3: 蓝色石纹斜背包 [sim=0.3262]
d2: 米色帆布横式侧背包 [sim=0.3017]

问题是一字字断词破坏中文词意

Searching 包布 in 7 documents ...

Top 3 similar documents are:
d2: 米色帆布横式侧背包 [sim=0.2981]
d1: 复古单宁帆布后双背包 [sim=0.2762]
d7: 单眼相机用亮彩防水包布 [sim=0.2459]

包布 ≠ 布包 ≠ 布○○包。我们需要更好的分词模式。

中文的断词应该像这样

过去很近,近的就在眼前,以致于你一集中焦距就看出了它的远。
张惠菁。《你不相信的事》

Jieba
中文
断词

中文断词我们选择 jieba

Jieba in action

'/'.join(jieba.cut(
      '过去很近,近的就在眼前,'
      '以致于你一集中焦距就看出了它的远。'))
# 过去/很近/,/近/的/就/在/眼前/,/
# 以致于/你/一/集中/焦距/就/看出/了/它/的/远/。

'/'.join(jieba.cut('穿过县界长长的隧道,便是雪国。'))
# 穿过/县界/长长的/隧道/,/便是/雪国/。

Jieba HMM in action

'/'.join(jieba.cut('便是雪国', HMM=True))
# 便是/雪国
'/'.join(jieba.cut('便是雪国', HMM=False))
# 便是/雪/国

在中文,二字二字成词比后者的组合机会高得多
(极端的例子:「科科科科科」也会被拆成「科科/科科科」

Some people, when confronted with a Chinese segmentation porblem, think "I know, I'll use a dictionary look-up." Now they have two problems.(An super old meme)

cut('相机包布')           # 相机包 / 布
cut('台中太阳饼')         # 台 / 中 / 太阳 / 饼
cut('侧背包 侧肩背包')     # 侧背包 / 侧肩 / 背包

实际上 jieba 内置的字典并没有这个问题,但我觉得这个例子比较简单

侧背包≠ 侧肩 + 背包?!

  • 用户查「侧背包」
  • 产品里有个「侧肩 / 背包」
  • ES 的行为:
    1. 侧背包 in 侧肩?否
    2. 侧背包 in 背包?否
    3. 回传找不到相关商品
  • 用户查「侧 / 背包」
  • 产品里有个「侧肩 / 背包」
  • ES 的行为:
    1. 侧 in 侧肩?是
    2. 背包 in 背包?是
    3. 回传找到相关商品

断词不是切越长越好!查不到比查不准还惨……有没有改进方法?

Jieba search(index in ES) mode

解决上述复合词断词问题,能要求 jieba 把可能的断词组合都列出。

cut_for_search('侧背包')     cut_for_search('帆布鞋')
# 背包 / 侧背包              # 帆布 / 布鞋 / 帆布鞋

但并不能完全解决问题,有时候会缺字注,在这里就少了个「侧」词。用户能查到背包但缺乏「侧」的消息。
另外词变多了,会增加搜索的负担。

注:推估原因是 jieba 内置的 HMM 没有繁体字 ,所以 \(P(\text{侧}|B) = 0\) 新词

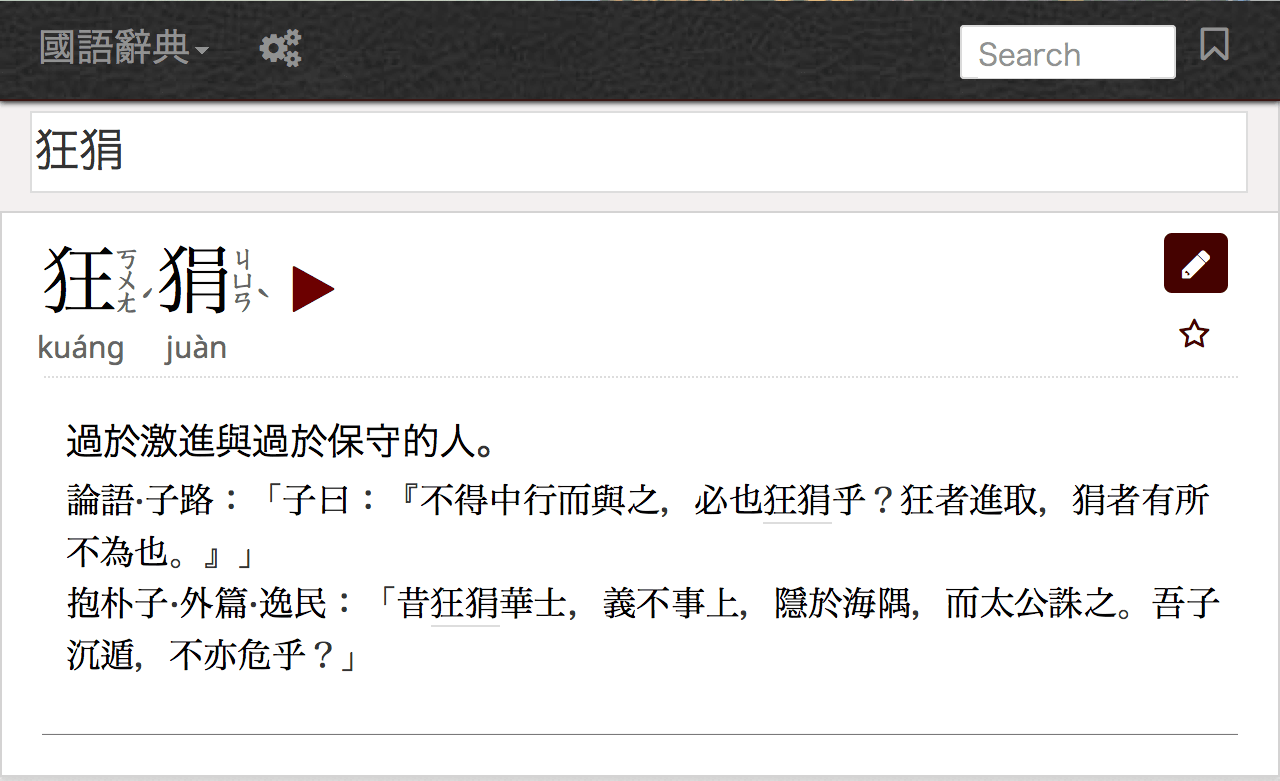
断词词典与词频要小心

萌典

让 jieba 使用萌典

ES Search 总结

Semantic Search

仍有一成的搜索找不(太)到结果

  1. 其实找到用户想找的东西了
  2. 用户想找的是同义的商品,但用词不同
  3. 下太多关键字,站上就没有这样的商品

也许没有完全一样的,但也许很像的

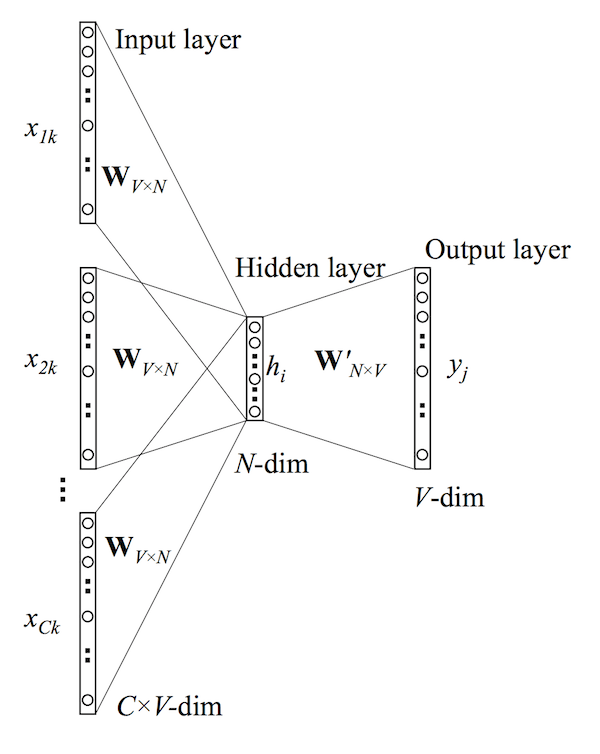
Word2vec theory

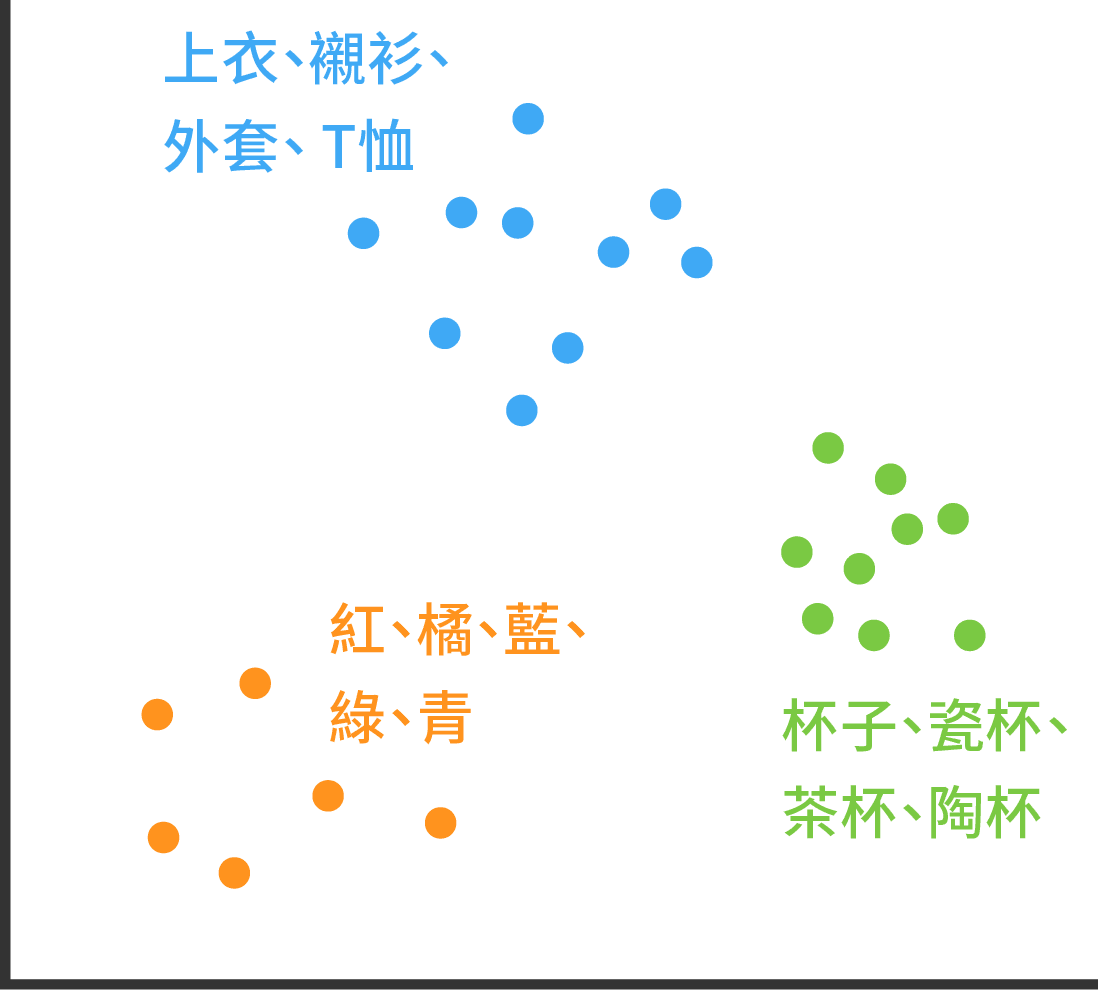
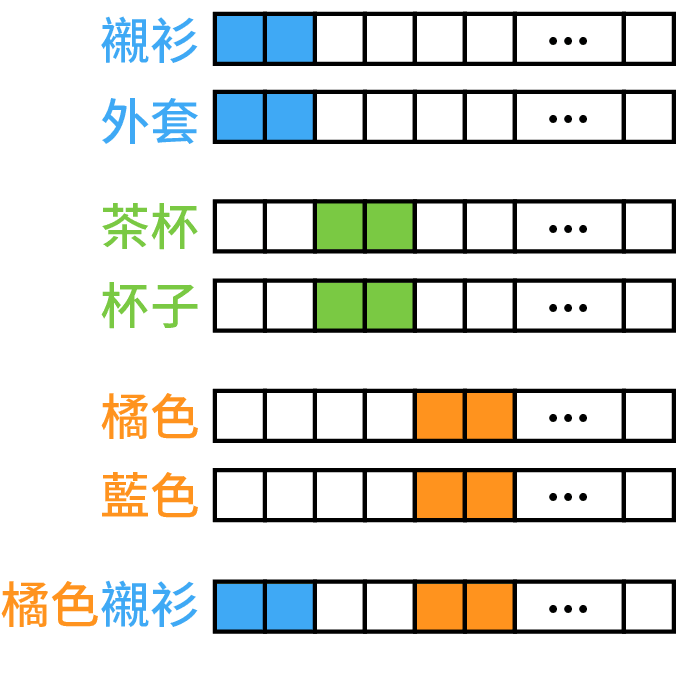
  • 一个词会被转换到 \(V\) 维度的空间中,\(V \in [200, 1000]\)
  • 这个转换透过给的文本前后文去学习,例如 \( C = 10\) 表示看了前后 5 个字
  • Unsupervised:只要一直喂给他断好词的文本就可以了
  • 使用 wiki,一次 iteration 后就有效果

Word2vec 空间特性

  • 概念上接近的东西会很接近
  • 可能因为他们在文本中经常一起出现、在文本中的位置很接近
  • 虽然未必精准(钥匙、门锁、门、木板)

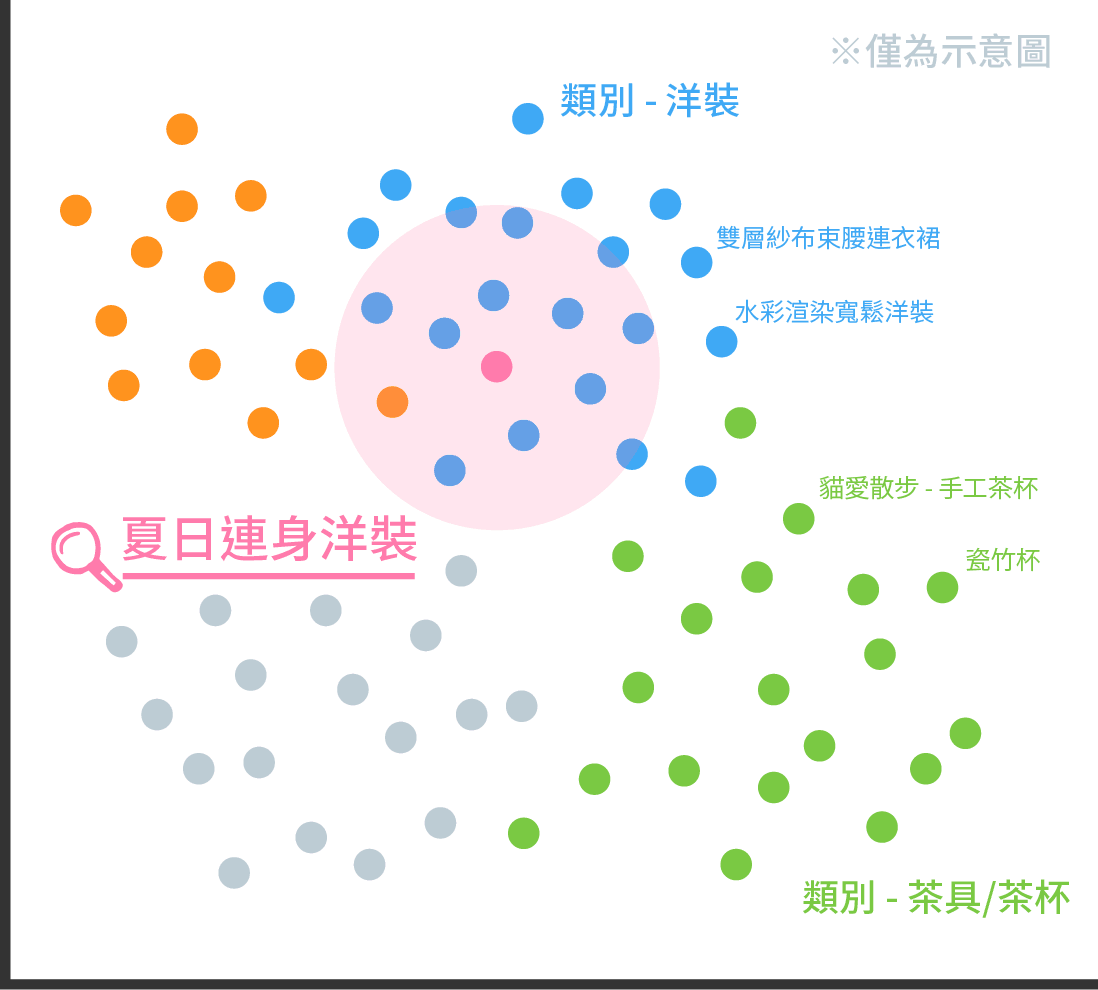
实际上座标空间有 V 维,这个可以想成映射在某个平面空间时

  • 每个维度大致上控制「某个概念」
  • Unsupervised learning 并无法掌控、指定哪个维度应该是什么
  • 概念可以相加
  • 近年 LSTM RNN 这类模型也许可以做得更好,但相较而言, word2vec 架构简单多了

注:这是很理想的状况,现实中可能不会这么理想,相加的概念会被高频的单字 dominate。例如「○○茶」基本上就是「茶」,除非○○的词频够足以让 word2vec 的矢量够明确,例如「高山茶」就能与「茶」有所区别;像「伯爵茶」的「伯爵」概念就会被实际的「伯爵」所影响。
这时候就需要更精细的断词系统。
使用中文维基的 word2vec

m.most_similar(['项链'])
坠子       	0.798
项链       	0.736
坠        	0.707
坠饰       	0.684
链长       	0.682
锁骨       	0.681
链        	0.664
炼        	0.662
墬        	0.650
纯银       	0.649
m.most_similar(['背包'])
束口       	0.713
圆筒       	0.617
书包       	0.591
背袋       	0.587
侧        	0.582
中型       	0.572
手提包       0.571
肩背       	0.571
后背       	0.544
斜背       	0.539
m.most_similar(['高山茶'])
乌龙茶      	0.722
阿里山      	0.715
茶        	0.708
蜜香       	0.685
金萱       	0.683
包种茶      	0.681
红茶       	0.681
高山       	0.677
乌龙       	0.675
茶农       	0.670
m.most_similar(['高山', '茶'])
阿里山      	0.837
乌龙       	0.818
乌龙茶      	0.795
红茶       	0.794
金萱       	0.786
茶叶       	0.769
高山茶      	0.765
绿茶       	0.752
茶园       	0.742
手采       	0.741

Demo

Demo 2

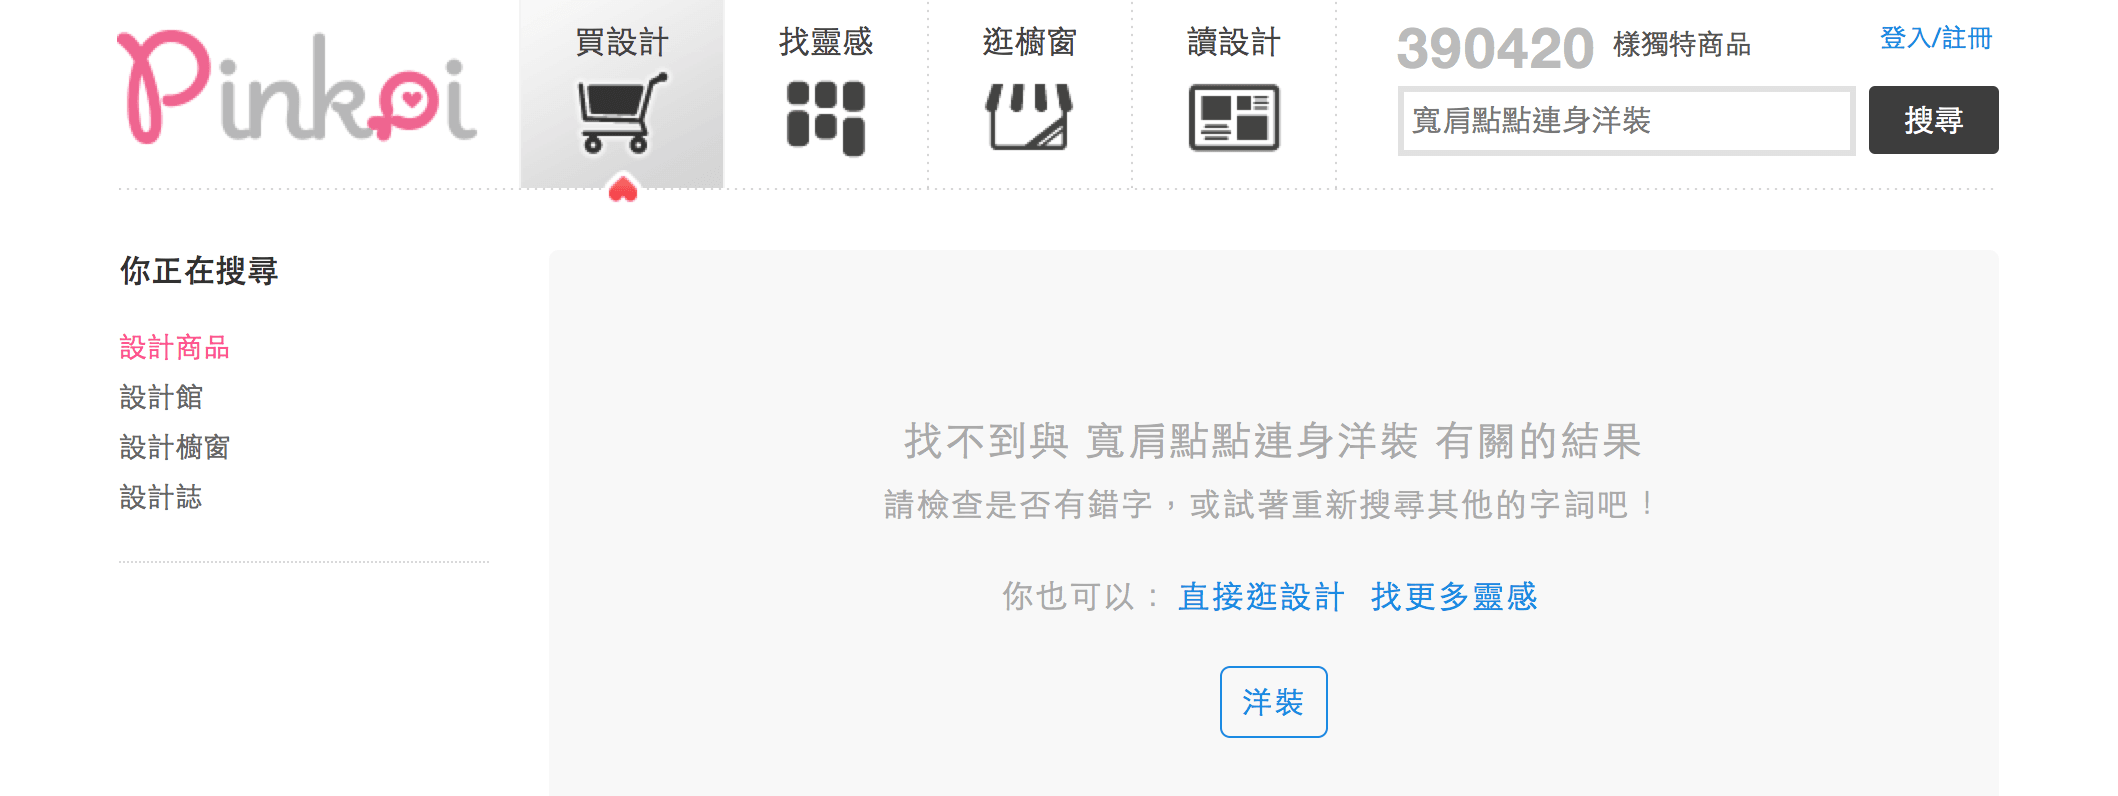
🔍 宽肩点点连身洋装

  • 大点点罩衫洋装
  • 双色点点棉洋装
  • 点点蝴蝶结背心长洋装
  • 长长背心裙洋装
  • 点点洋装

Word2vec 总结

What's next for ?

我们关心并努力改善来自各地的用户体验

Pinkoiis hiring

Back-End | QA | Data | Search
Front-End | iOS | Android
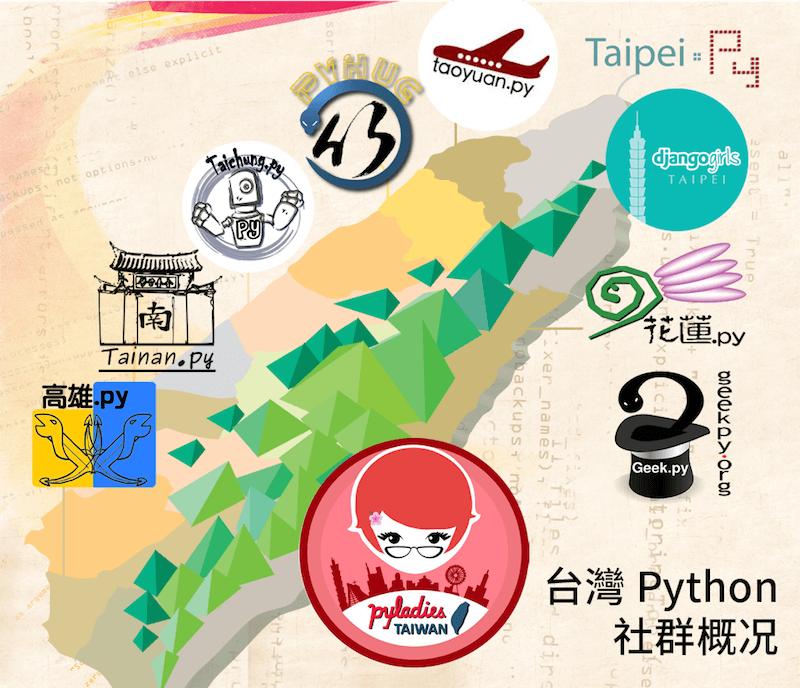
台湾 Py 社群近况

北中南东西各地 Python 社群

欢迎大家,环岛兼参加各地聚会!

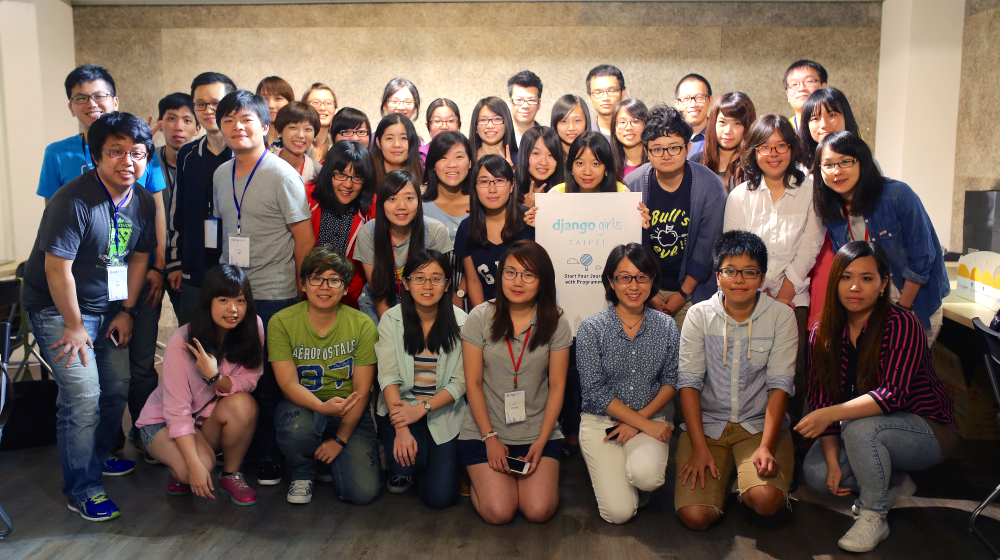
去年新成立了
Django Girls Taipei

(制图:Mimi Xu)

  • 约一个月聚会一次
  • 除了带新手,也再培养未来讲师
  • 定期与 Py web 聚会合办
  • (资料由主办人 Michelle 提供)

Questions?

Fork me on Github